Plateformes d'observabilité et d'analyse de performance conçues pour un grand groupe d'assurance : de la production de la donnée à sa restitution, jusqu'à l'automatisation de l'analyse par intelligence artificielle.
Trois produits intégrés qui partagent le même référentiel et les mêmes données de production : la carte vivante du SI, la supervision temps réel des parcours applicatifs et l'analyse de cause racine par IA — du symptôme à la cause, sans changer d'outil.
✦
Observability AI
Demandez. L’IA enquête, chiffre et conclut.
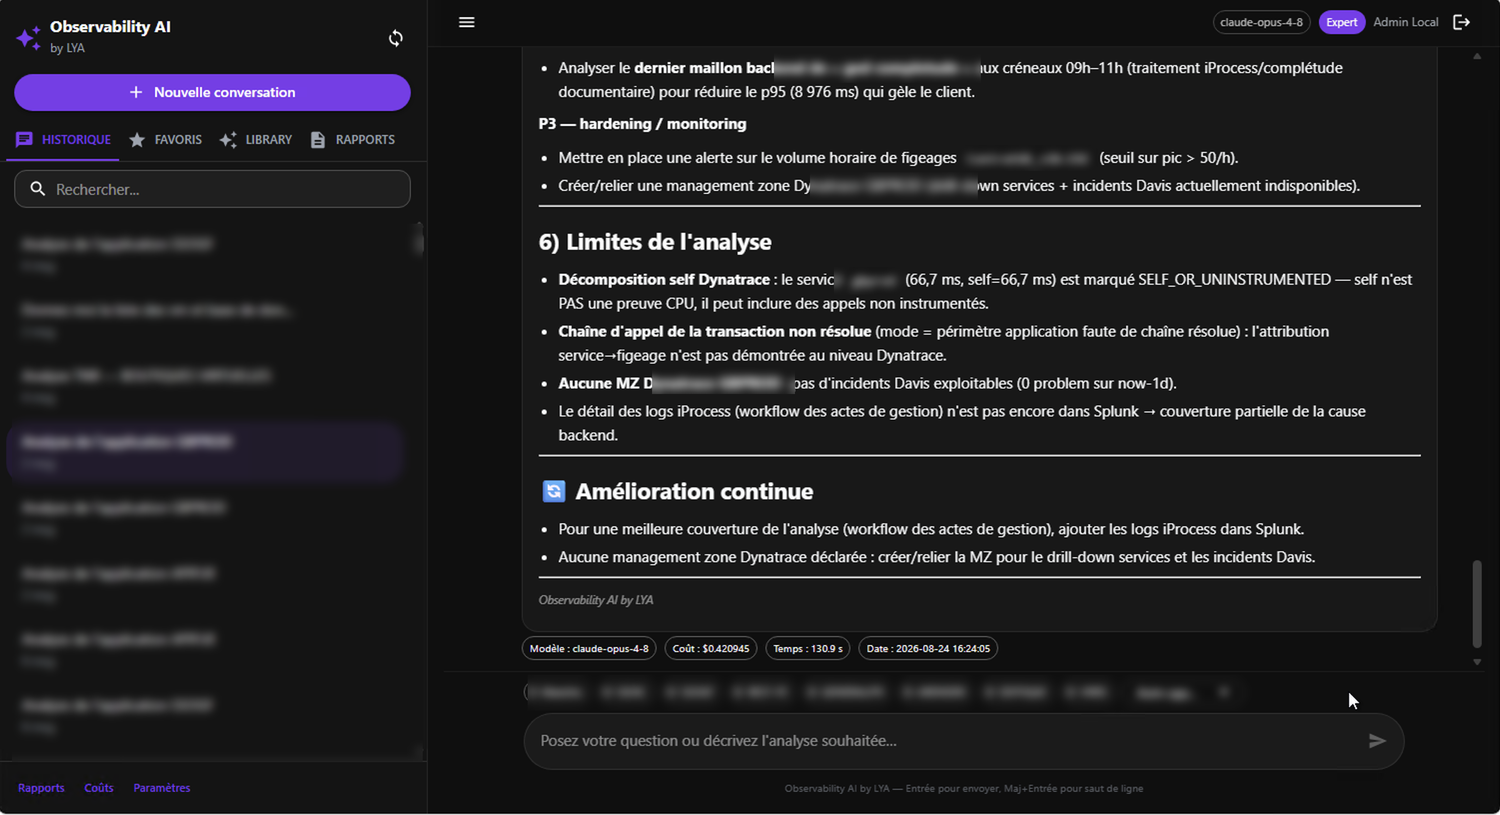
Une question en langage naturel suffit : l'assistant croise les sources d'observabilité, l'APM, l'ITSM, les logs, les bases et le mainframe, vérifie chaque chiffre à la source et livre un rapport de cause racine complet — dans le chat, en PDF ou en carte de messagerie.
RCA automatisée
Multi-sources
Chiffres vérifiés — zéro hallucination
Rapports PDF & Teams
Rapport de cause racine généré en autonomie. La section « limites de l’analyse » est produite par l’outil lui-même : il dit ce qu’il n’a pas pu démontrer.
◈
Observability Monitoring
La santé du run, en un coup d’œil.
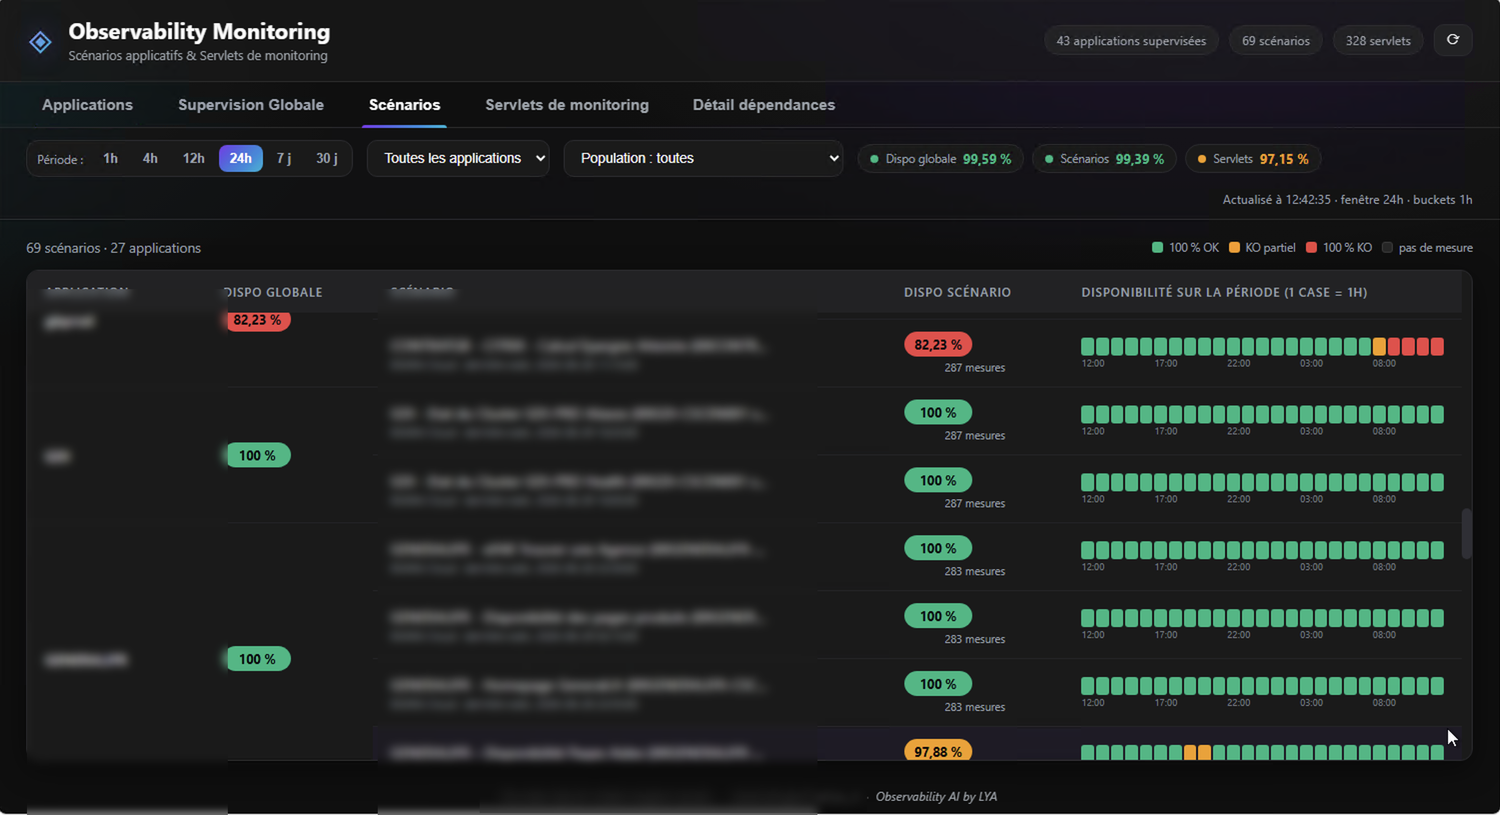
Scénarios applicatifs et sondes de monitoring agrégés en une vue de disponibilité unique, avec heatmaps de 1 h à 30 jours et arbre de dépendances interrogé en direct.
Disponibilité temps réel
Heatmaps 1 h → 30 j
Scénarios & sondes
Sonde live des dépendances
Scénarios et sondes agrégés en une disponibilité unique, avec la heatmap horaire — une case par heure, la dégradation se voit à l’œil.
◎
Observability Inventory
Le SI, cartographié. Et vivant.
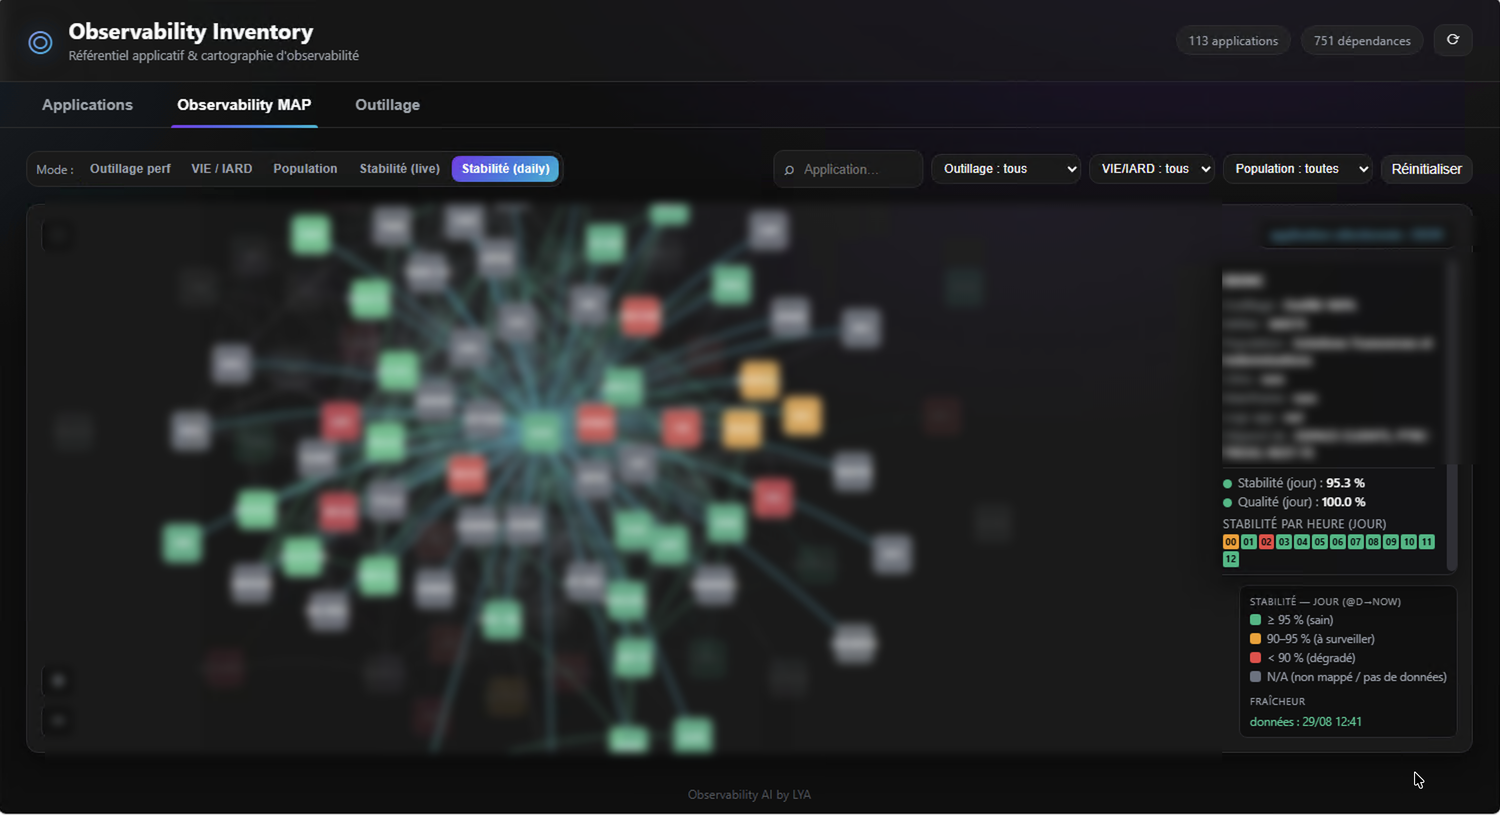
Le référentiel unique de l'observabilité : les applications et leurs dépendances, issues de l'APM et des cartographies déclaratives, avec la stabilité du jour colorée sur chaque nœud — le statut de la production se lit sur la carte.
Carte de stabilité quotidienne
113 applications
750+ dépendances
Référentiel versionné — mise à jour auto
La stabilité du jour projetée sur la carte des dépendances : l’état de la production se lit sur la topologie, pas dans un tableau.
360°Un même référentiel,
trois angles complémentaires
113applications
cartographiées
750+dépendances
327sondes
supervisées
24/7collecte
& analyse
Les captures d'écran sont réelles. Les éléments appartenant au client — logos, noms d'applications, noms de serveurs et d'instances, identifiants d'infrastructure — y sont volontairement masqués.
Grand groupe d’assurance — 2024-2026
Observability AI — analyse de performance automatisée
Assistant IA
Une analyse de performance mobilisait un expert plusieurs heures : ouvrir l'outil de logs, croiser l'APM, chercher les changements dans l'ITSM, vérifier les bases de données, puis remettre le tout en forme. L'application industrialise cette démarche : l'incident est décrit en langage naturel, la chaîne d'investigation s'exécute, un rapport PDF exploitable en sort.
Routage déterministe des intentions (stabilité, RCA applicatif, ITSM, réseau, mainframe, base de données)
Exécution de « piliers » d’analyse chaînés, avec baseline automatique à J-7 et corrélation des changements
Garde-fou anti-hallucination : toute affirmation du rapport est adossée à une mesure réellement collectée
Historique des conversations, bibliothèque de rapports, suivi des coûts LLM, mode expert
Diffusion multi-canal : rapport PDF brandé, carte adaptative sur la messagerie d’équipe, e-mail
Évaluation à l’échelle : campagne d’analyses sur l’ensemble du parc, avec score de fiabilité par analyse, et audit « replay » qui rejoue des analyses pour vérifier chaque chiffre contre sa source
Industrialisation : livraisons itératives, chacune validée par des tests de bout en bout en conteneur sur données réelles avant la mise en production
Sécurité : correctifs issus d’un scan de code (images sans privilèges, versions de dépendances figées)
Gouvernance : dossiers de design review de l’IA générative et de co-architecture, prérequis techniques (dimensionnement, flux)
Résultats
Analyse ramenée de plusieurs heures d’expert à quelques minutes
Le modèle de langage n’accède jamais aux données brutes : il orchestre des outils, il ne les remplace pas
Connecteurs temps réel vers plus de six systèmes sources : journaux, APM, ITSM, réseau, bases de données, mainframe, poste de travail
Campagne d’analyses sur 113 applications avec score de fiabilité ; audit « replay » de 23 analyses : chiffres vérifiés exacts face aux sources
Près de 190 versions livrées, chacune éprouvée sur données réelles avant la mise en production
Python
FastAPI
PostgreSQL
React
TypeScript
SSE
LLM (tool-calling)
MCP
Redis
Docker Compose
Grand groupe d’assurance — 2025-2026
Observability Inventory — référentiel vivant du parc applicatif
Référentiel & cartographie
Impossible de répondre simplement à « cette application est-elle supervisée ? » ou « qu'est-ce qui tombe si ce composant tombe ? ». Les dépendances vivaient dans des cartographies dessinées à la main, incomplètes et vite périmées. L'application recompose ce référentiel automatiquement et le confronte en permanence à la réalité des données.
Carte de dépendances force-directed développée sur mesure en SVG (zoom, déplacement, isolation d’un nœud)
Enrichissement automatique depuis l’APM (relations d’appel observées) et depuis les référentiels déclaratifs
Matrice de couverture d’outillage : APM, stabilité, qualité, logs, infrastructure
Audit nocturne direct — ce qui est déclaré existe-t-il réellement ?
Audit nocturne inverse — qu’est-ce qui produit des données sans être référencé ? Détection des gisements de logs orphelins
Résultats
113 fiches applicatives et plus de 750 dépendances maintenues automatiquement
Statut de stabilité rafraîchi toutes les 5 minutes
Le référentiel ne peut plus dériver : deux audits croisés le confrontent chaque nuit aux données réelles
Python
FastAPI
JavaScript
SVG
YAML
cron
Grand groupe d’assurance — 2025-2026
Observability Monitoring — disponibilité de bout en bout
Supervision applicative
Les sondes techniques et les scénarios de navigation produisaient un volume important d'événements, mais aucune restitution transverse : impossible de dire quelle application était réellement disponible, ni de descendre jusqu'au test technique en échec. L'application reconstruit cette chaîne, du taux de disponibilité global jusqu'à la sonde défaillante.
Arbre application → serveur → contexte web → sonde, avec interrogation temps réel au clic
Heatmaps agrégées côté moteur de recherche pour tenir la volumétrie
Filtres transverses par période (1 h à 30 j), application et population d’utilisateurs
Sonde live protégée contre le SSRF par liste blanche d’hôtes
Résultats
43 applications supervisées, 69 scénarios et 327 sondes techniques
Règle de disponibilité définie avec le métier : une sonde technique secondaire en échec ne déclare plus une application indisponible
Python
FastAPI
JavaScript
JSON-RPC
XML
Grand groupe d’assurance — 2026
Portail unifié Observabilité & Performance
Plateforme
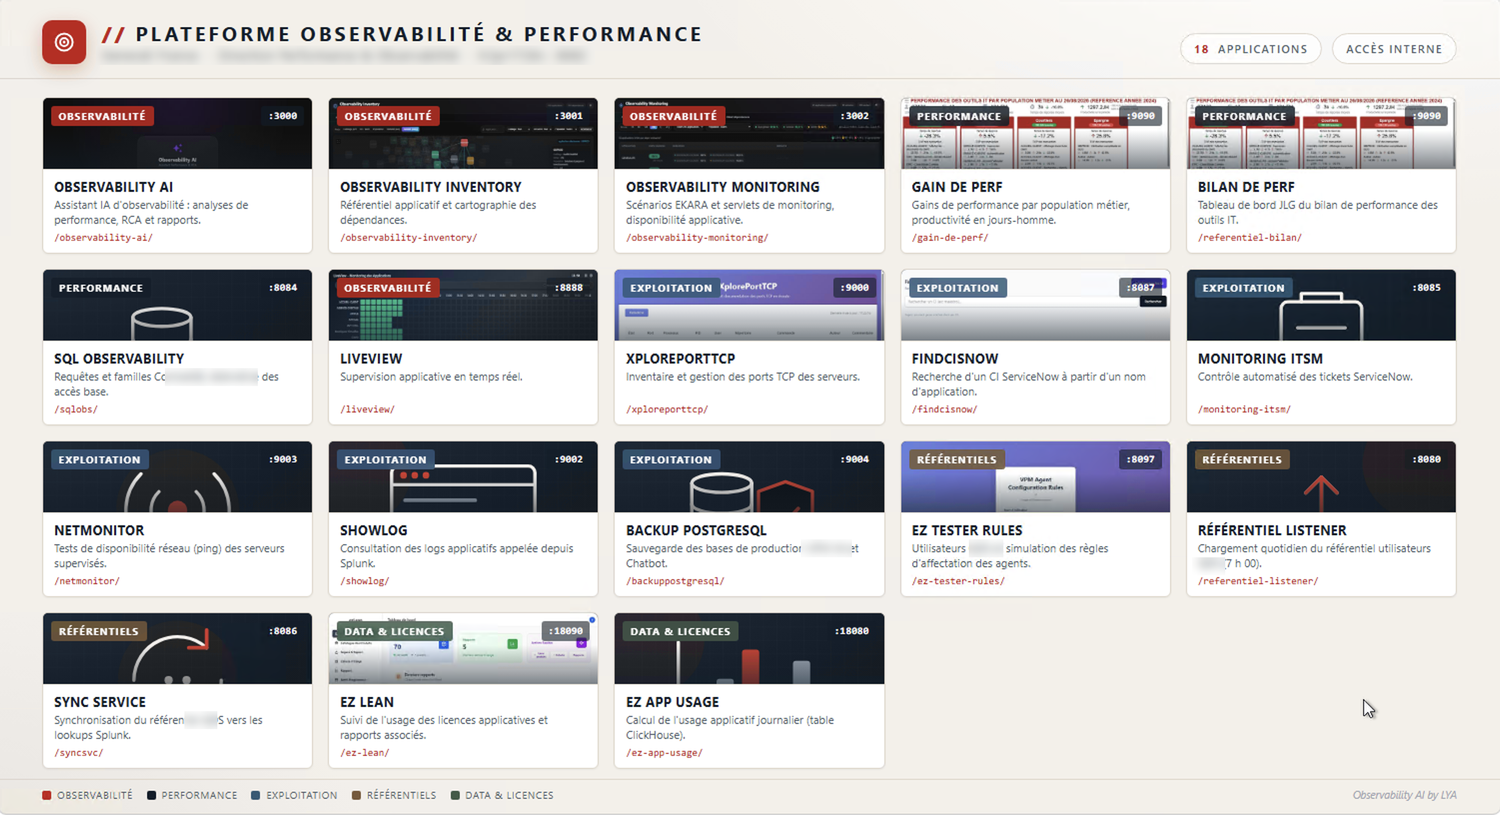
Les outils de l'équipe étaient dispersés sur une dizaine de ports d'un serveur, chacun avec son URL à mémoriser — et une partie de ces ports était filtrée depuis les postes clients : l'outil tournait mais restait injoignable. Le reverse proxy, lui, était mutualisé avec quatorze applications d'autres équipes : impossible de le réécrire.
Contrainte structurante : ne modifier aucune ligne de configuration existante, le proxy étant partagé
Autorisation insérée avant la règle de blocage terminale, plutôt que modification de cette règle critique
Désambiguïsation par en-tête Referer pour les applications appelant des ressources à la racine
Encapsulation d’une application au routage côté client, qui perdait son préfixe derrière le proxy
Bascule en URL relative d’un outil qui pointait vers un port filtré depuis les postes
Patches de configuration idempotents, sauvegarde horodatée et validation syntaxique avant tout rechargement
Résultats
18 outils accessibles en un clic depuis un seul écran, sans défilement
Zéro ligne de configuration des équipes tierces impactée
Procédure de réinstallation scriptée, configuration de référence versionnée
HAProxy
HTML/CSS
Python
PowerShell
Grand groupe d’assurance — 2026
Capacity planning des bases Sybase — prévoir la saturation
Capacity planning
Le capacity planning des bases de données reposait sur un exécutable local et une spécification fonctionnelle : pas de vue partagée, pas d'alerte, pas d'historique centralisé. Le seul indicateur disponible dans la plateforme était un cumul appauvri, un point par jour sur cinq bases. L'application reconstruit la chaîne complète, de la collecte à la date de saturation prévue.
Découverte de la donnée : identification des flux de supervision équivalents aux tables de la spécification — la table citée n’existait pas, le modèle logique a été reconstitué
Collecte par API : vingt inputs de production horaires aux créneaux étalés, avec reprise d’historique à J-90 (~836 000 lignes) et correction d’un défaut de point de reprise du connecteur de base
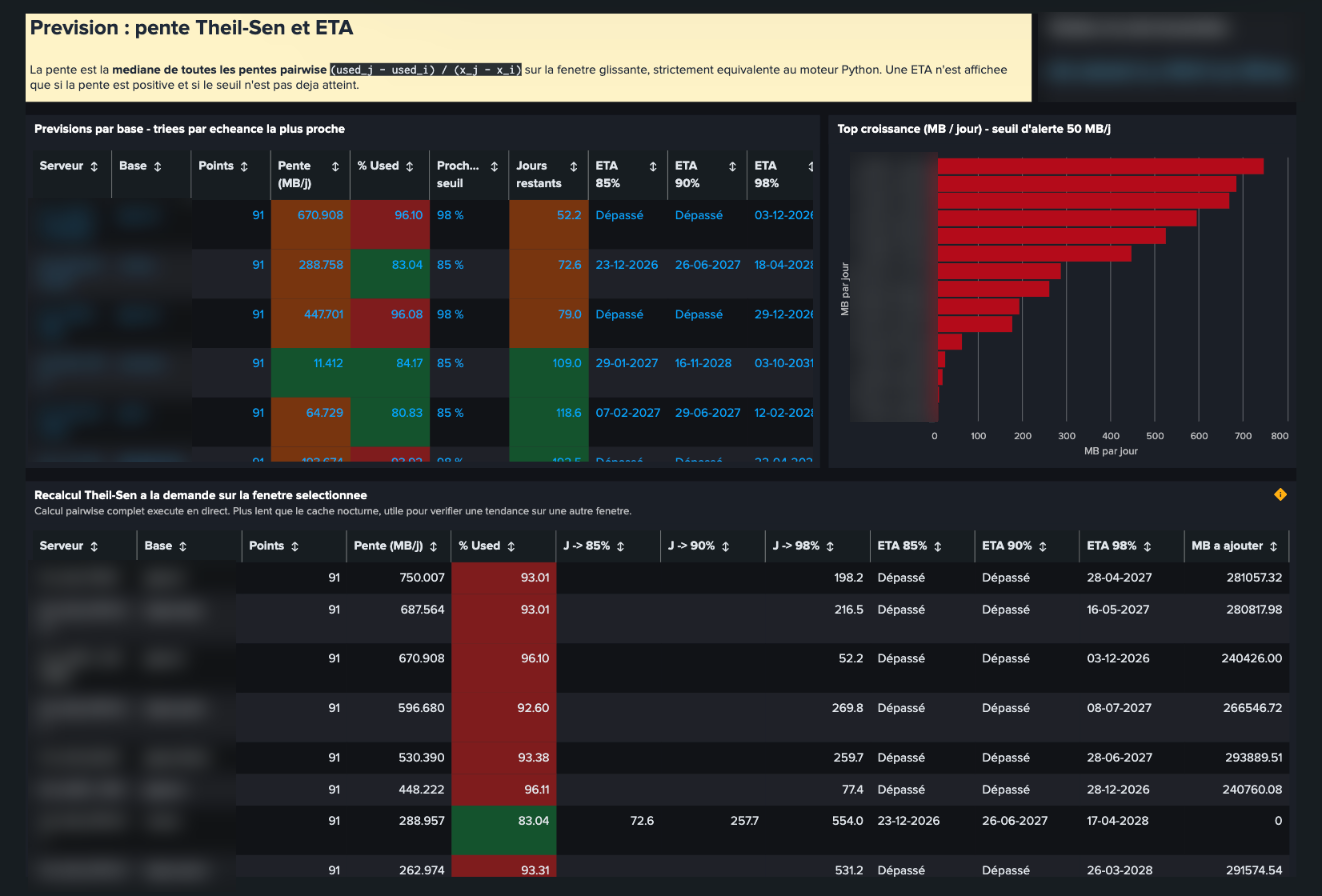
Prévision robuste par régression de Theil-Sen en SPL pur — médiane des pentes, sans commande Python sur mesure à faire valider sur la plateforme cloud ; calcul nocturne, résultat en KV Store relu par les tableaux de bord
Date de saturation estimée pour chaque base, aux seuils de 90, 95 et 98 %
Six tableaux de bord avec navigation chaînée, huit alertes par courriel hiérarchisées et protégées contre l’inondation, macros paramétrables — aucune valeur en dur
Production (10 instances) et hors production (32) strictement isolées, avec un bandeau de couleur distinct pour éviter toute confusion
Premier périmètre analysé en détail : 3 instances de production, 45 bases physiques, 15 bases métier, 11,4 To
Un classement par taux d’occupation donne la mauvaise priorité : une base à 95 % dont la taille décroît (purges) passe après une réplique à 95 % qui croît de plusieurs centaines de Mo par jour — c’est la date de saturation qui remet les bases dans l’ordre
Un outil partagé, historisé et alertant, à la place d’un exécutable sur un poste
Splunk Cloud
SPL
DB Connect
KV Store
Dashboard Studio
Sybase ASE
Python
AppInspect / ACS
Grand groupe d’assurance — 2026
Météo BDD — le diagnostic d’une tranche horaire, partagé
Diagnostic base de données
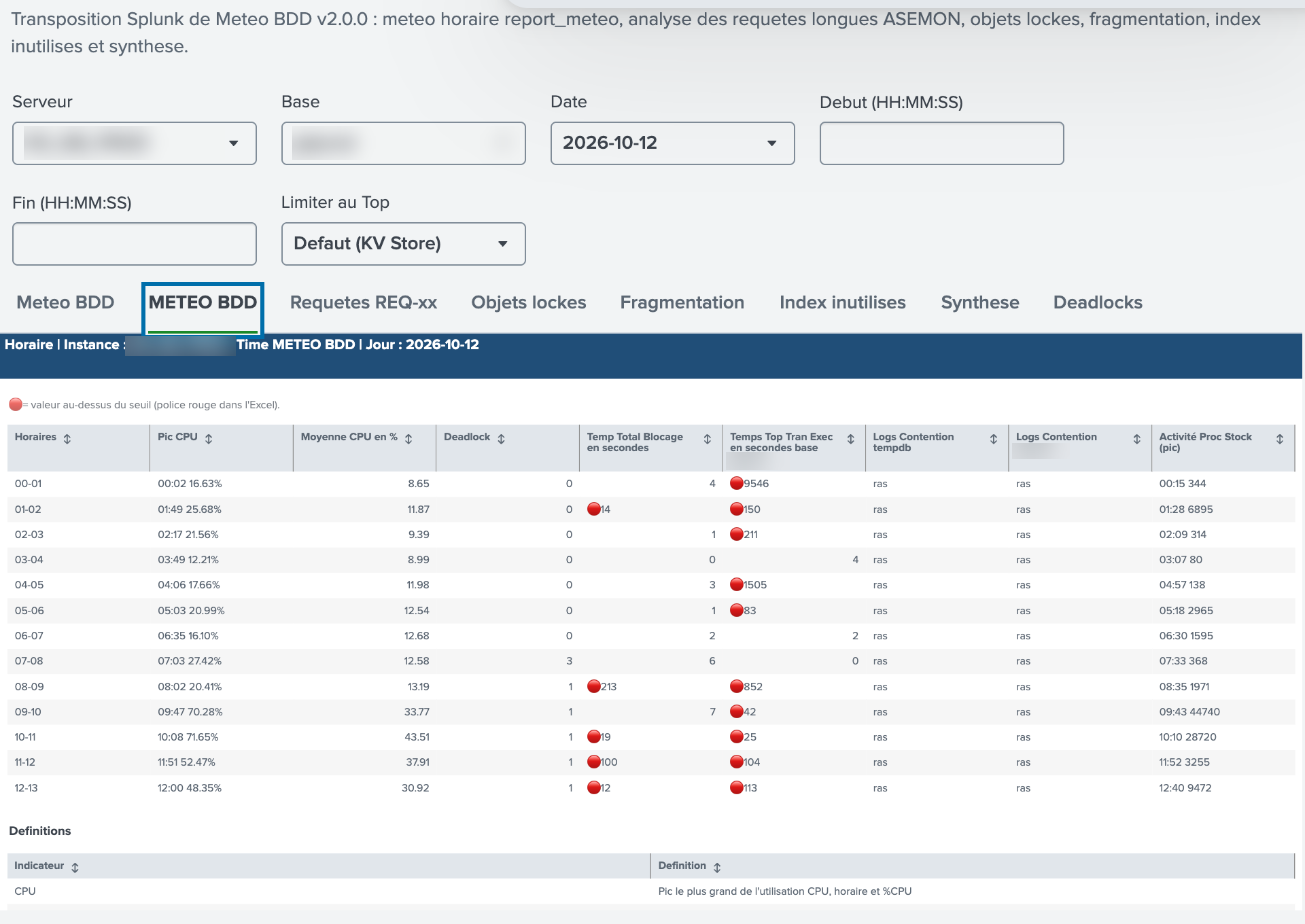
Les administrateurs de bases analysaient une tranche horaire d'un serveur avec un exécutable local : requêtes longues, régressions de plan, objets verrouillés, deadlocks, fragmentation, index inutilisés — le tout exporté dans un classeur. L'application transpose ce parcours dans la plateforme : le même geste, mais partagé, historisé, et qui alerte.
Parcours de l’outil d’origine conservé : serveur → base → chargement de la météo → clic sur une tranche horaire → un onglet par feuille de l’ancien classeur
Trois tableaux de bord : la météo (écran principal), la santé de la collecte et l’administration des seuils
Seuils administrables en KV Store par instance et par base, avec repli global, journal d’audit des modifications et écriture restreinte aux équipes habilitées
Onze recherches planifiées : quatre référentiels et sept alertes configurées (requête très longue, blocage prolongé, deadlock, régression de plan, fragmentation critique, collecte en retard, erreur de connecteur)
Collecte de douze serveurs de base, onze tables par instance, historique de 180 jours ; outillage Python de découverte en lecture seule et de génération des inputs
Optimisation des collectes : un filtre non indexable (conversion de la colonne horodatage, balayage complet, délais d’attente de 300 s sur des tables de 10 à 15 millions de lignes) remplacé par une forme indexable
Générateur d’application : tout le SPL centralisé, validateur de jetons Dashboard Studio, tests SPL en direct, captures automatisées, AppInspect puis déploiement ACS
Résultats
Première ligne en 1,5 s au lieu d’un délai d’attente dépassé sur les plus grosses tables collectées
Fidélité vérifiée sur données réelles : Top 5, objets verrouillés, fragmentation, index inutilisés, régressions et score de criticité identiques au classeur de l’outil d’origine
Deux anomalies de l’outil d’origine détectées et corrigées : empreintes de requêtes mal signées (statut « aucune référence » à tort) et millisecondes mal lues
Un outil partagé et historisé, lisible par plus de 1 500 utilisateurs ; écriture des seuils réservée aux équipes habilitées
Splunk Cloud
SPL
DB Connect
KV Store
Dashboard Studio
Sybase ASE
Python
Playwright
Grand groupe d’assurance — 2026
Portail de navigation Splunk — menu d’équipe v3
Plateforme
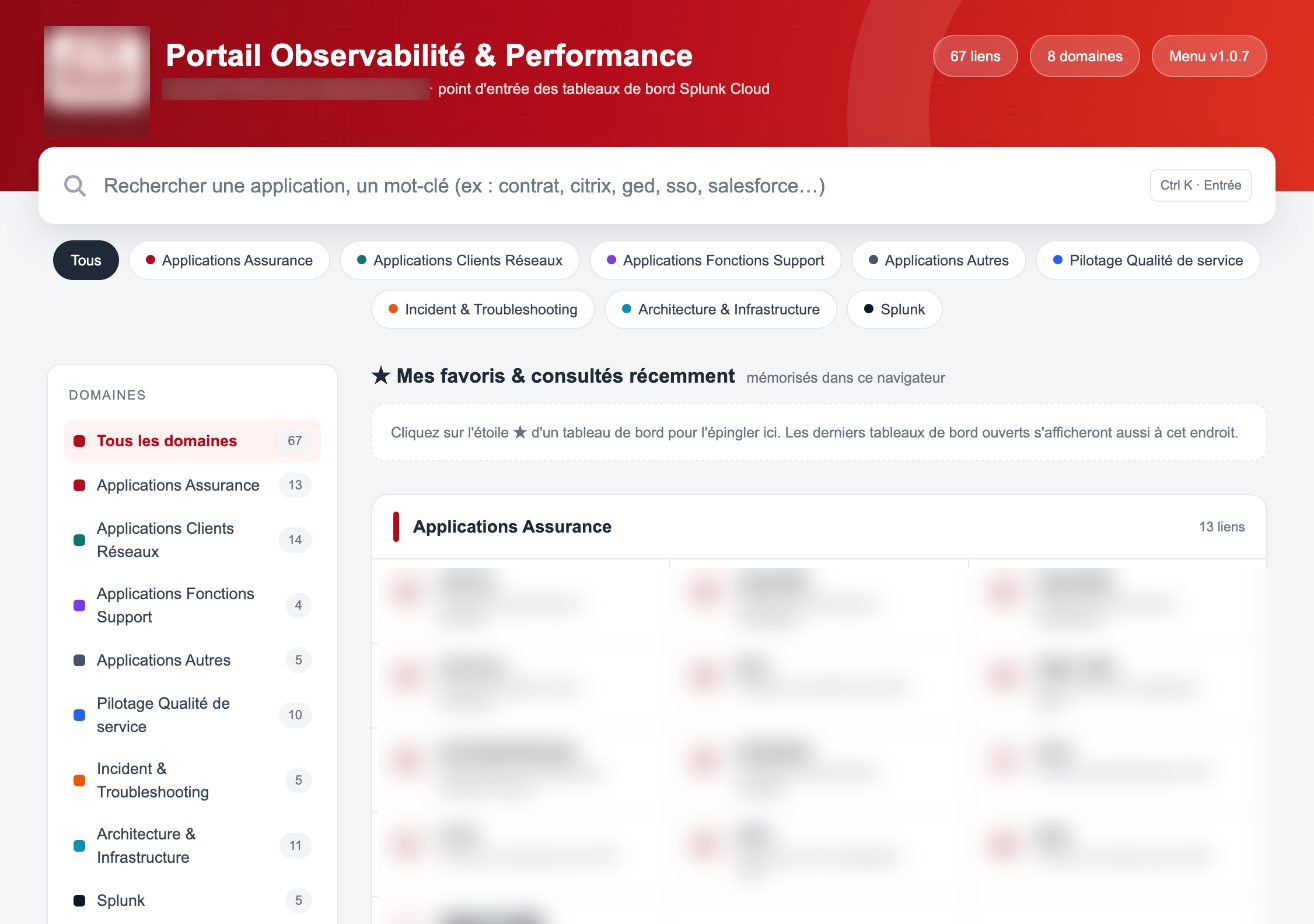
Le menu de navigation de l'équipe était l'unique point d'entrée vers une soixantaine de tableaux de bord, mais il contenait des liens tronqués, une structure non conforme aux règles de la plateforme cloud et un design daté.
Mise en conformité du paquet pour la plateforme cloud : nettoyage, tableaux de bord en version 1.1, validation AppInspect
Sept liens tronqués corrigés en retrouvant les véritables adresses dans les journaux d’accès web de la plateforme
Refonte du design : recherche instantanée, filtres par domaine, favoris stockés dans le navigateur, sans aucune dépendance à un CDN — compatible cloud
Piège de la plateforme corrigé : la navigation par défaut était surchargée localement, une relivraison du paquet ne la modifiait pas — correction ciblée par l’API REST
Rendu vérifié automatiquement en production par capture d’écran
Résultats
67 tuiles vérifiées en production : un point d’entrée unique, avec recherche et favoris
Paquet conforme à la plateforme cloud, livré par une chaîne automatisée du contrôle au déploiement
Splunk Cloud
Dashboard Studio
JavaScript
AppInspect / ACS
Playwright
Grand groupe d’assurance — 2026
Tour de contrôle quotidienne — périmètre Épargne
Tour de contrôle
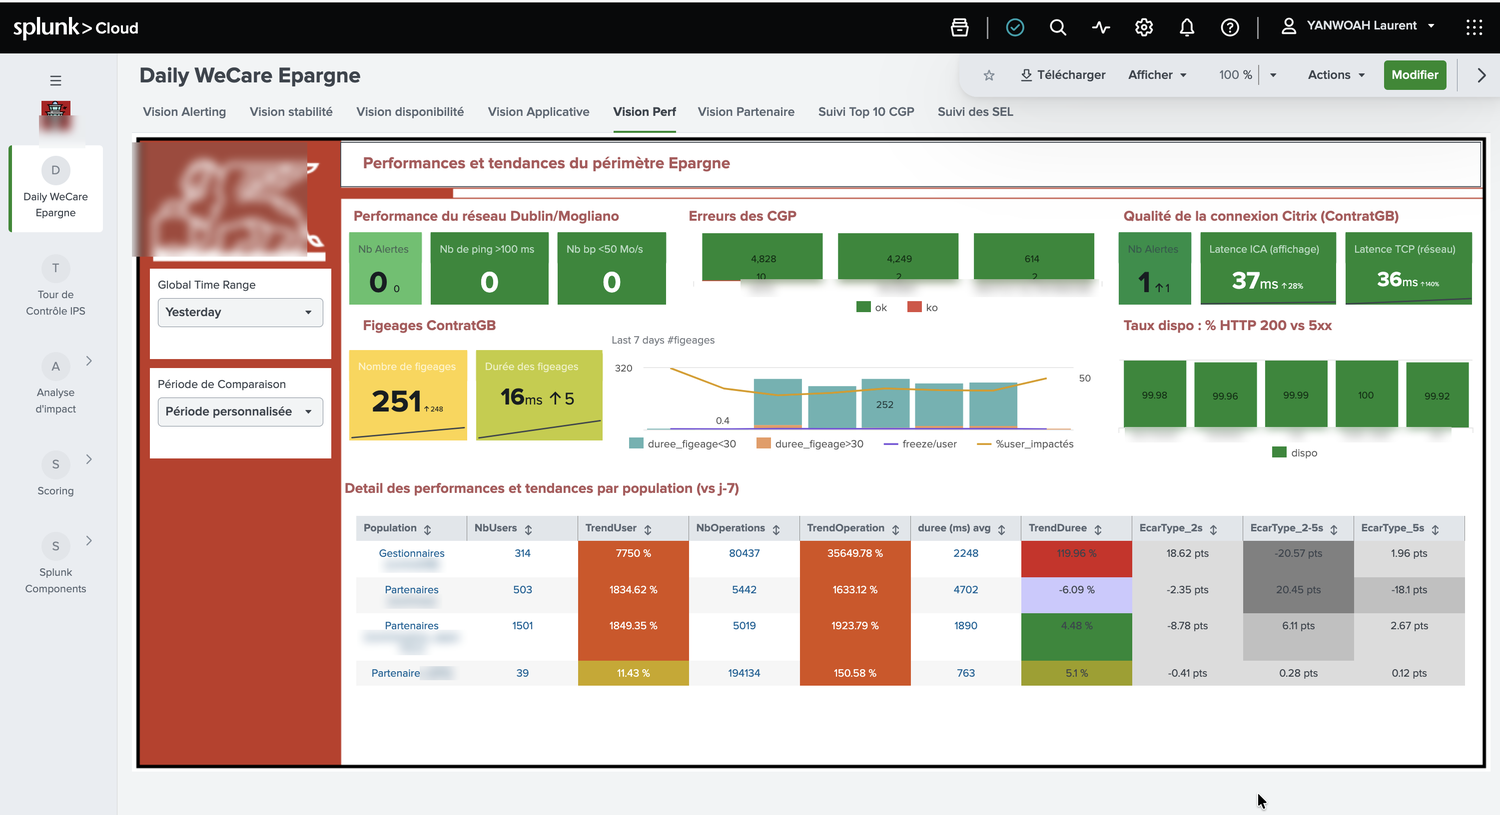
Le rituel de production quotidien du périmètre Épargne s'appuyait sur des sources dispersées. L'application les consolide en une revue unique, conçue pour être lue en séance.
Agrégation de trois familles de sources : sondes de supervision, index de stabilité calculé à 5 minutes, métriques d’infrastructure
Comparaison systématique du jour à J-7
Taux de disponibilité décliné par population d’utilisateurs
Espaces d’analyse d’impact et de scoring
Résultats
Support unique de la revue quotidienne de production
Suivi de la performance transactionnelle, de la latence réseau inter-sites et de l’expérience poste de travail dans un même écran
Splunk Cloud
SPL
Dashboard Studio
Grand groupe d’assurance — 2025-2026
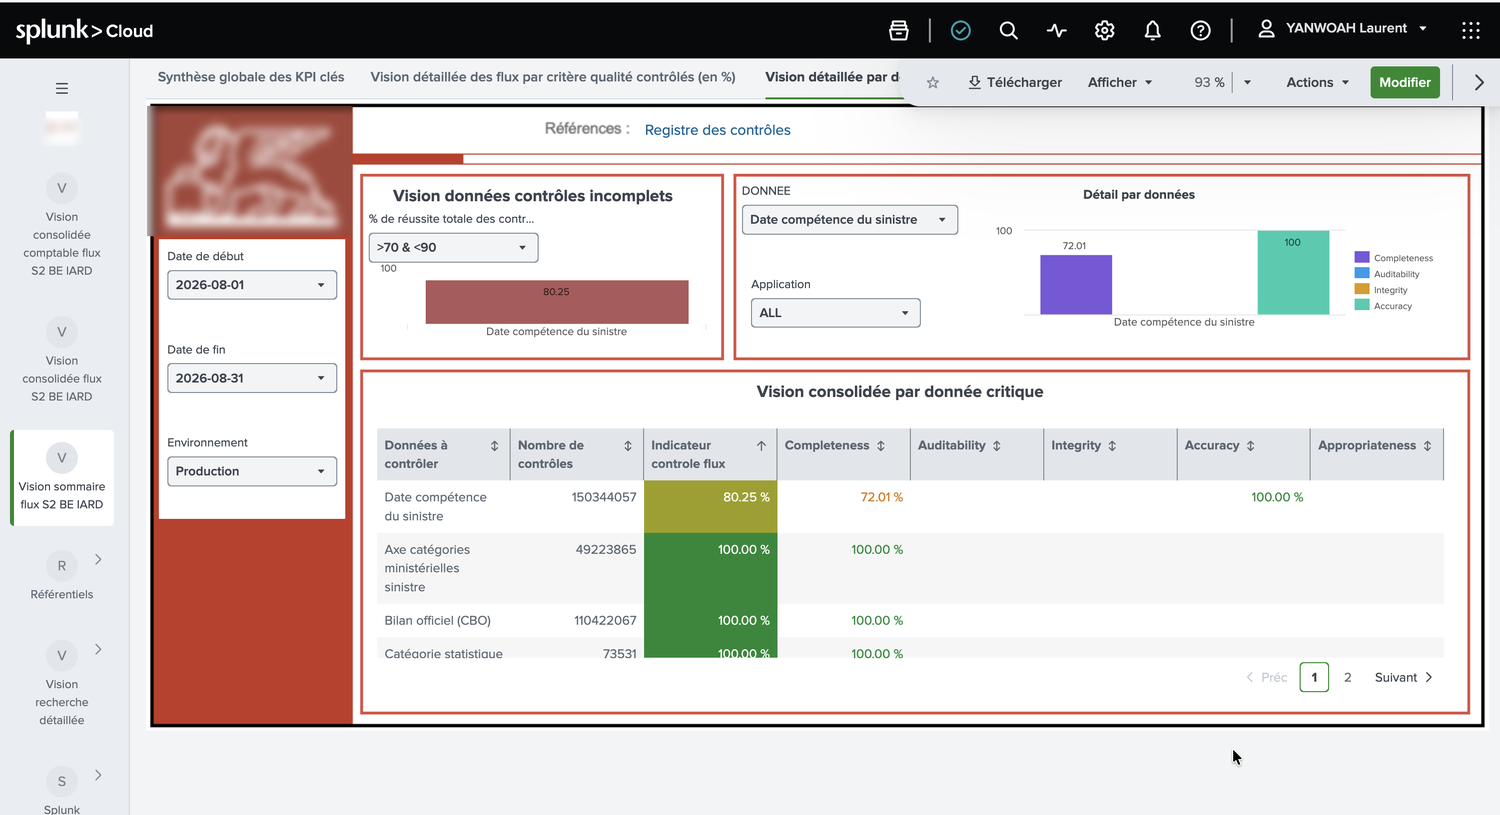
Contrôle qualité des flux réglementaires Solvabilité 2
Qualité de donnée
Les flux de données réglementaires alimentant la chaîne Solvabilité 2 devaient être contrôlés en qualité et en délivrabilité, à une volumétrie que les approches classiques ne tiennent pas.
Modèle de données dédié interrogé en mode accéléré, pour tenir des volumétries de l’ordre du milliard d’événements
Trois niveaux de restitution : vision sommaire, consolidée, et consolidée comptable
Croisement couple applicatif × flux × statut de délivrabilité × décompte des contrôles
Refonte de l’indicateur de délivrabilité : suppression des faux négatifs induits par des jointures à fenêtre temporelle figée, au profit d’une construction par référentiel juste pour toute mensuelle passée
Résultats
Jusqu’à 16,5 millions de contrôles suivis sur un seul flux, dont les écarts sont isolés ligne à ligne
Faux négatifs de délivrabilité éliminés — la cause était structurelle, pas paramétrique
Splunk Cloud
SPL
tstats
Dashboard Studio
Grand groupe d’assurance — 2025-2026
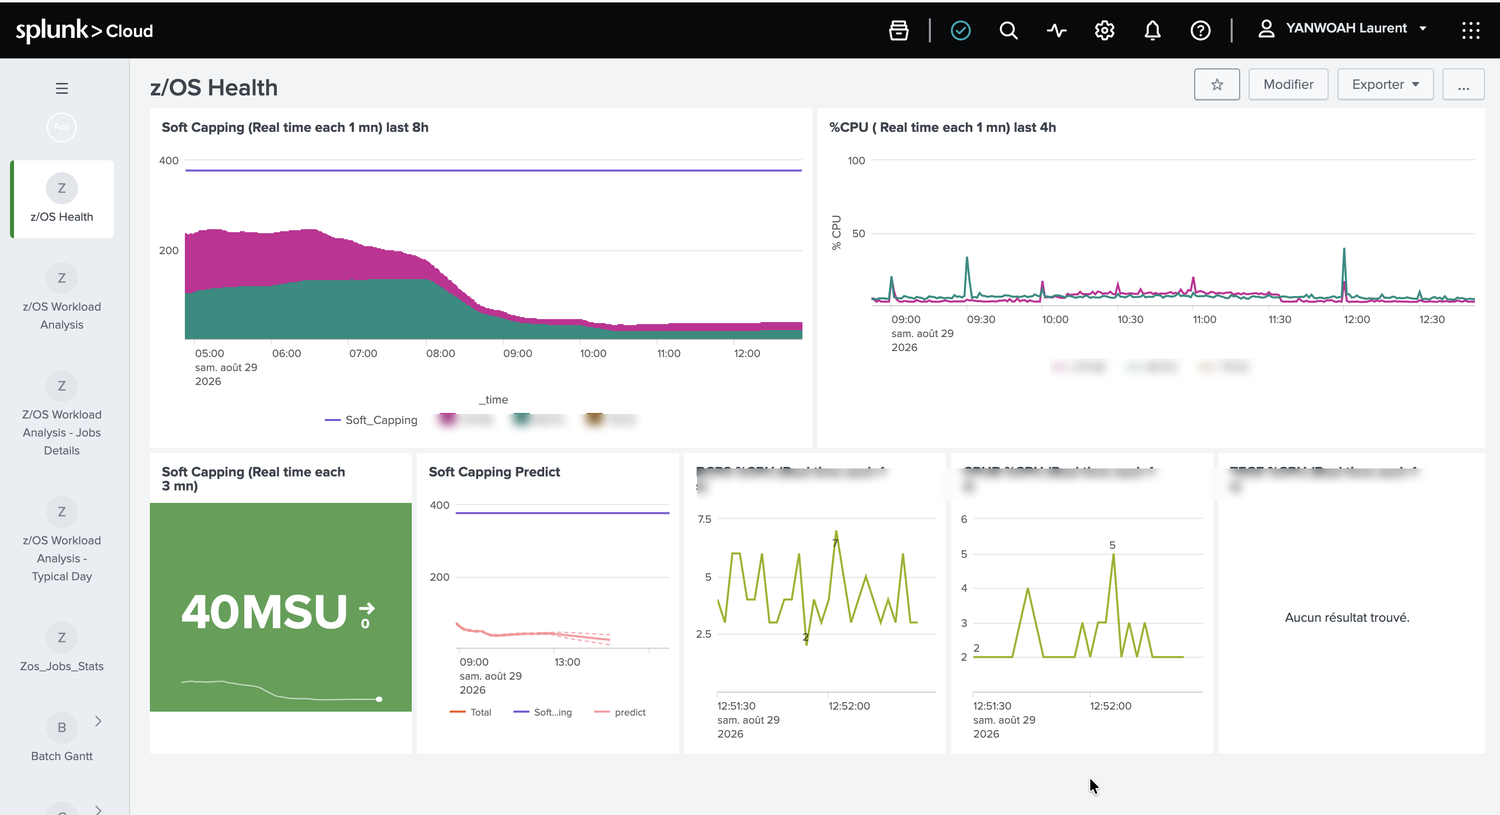
Analyse de charge mainframe et anticipation du bridage
Mainframe
La consommation du mainframe est plafonnée contractuellement. Le franchissement du plafond déclenche un bridage de la machine, dont l'effet se voit immédiatement sur les temps de réponse applicatifs — mais se constatait après coup.
Chaîne complète d’analyse de la charge : santé temps réel, journée type, détail des travaux batch, diagrammes de Gantt des chaînes
Statistiques par programme, performance des transactions transactionnelles, indicateurs de niveau de service
Comparaison continue de la consommation des partitions logiques à la limite contractuelle
Prédiction à 30 intervalles anticipant le franchissement du plafond
Résultats
Le bridage devient anticipable au lieu d’être constaté : l’équipe agit avant l’impact applicatif
Pourcentage de charge par partition rafraîchi à la seconde
Splunk Cloud
SPL
z/OS
enregistrements SMF
Grand groupe d’assurance — 2026
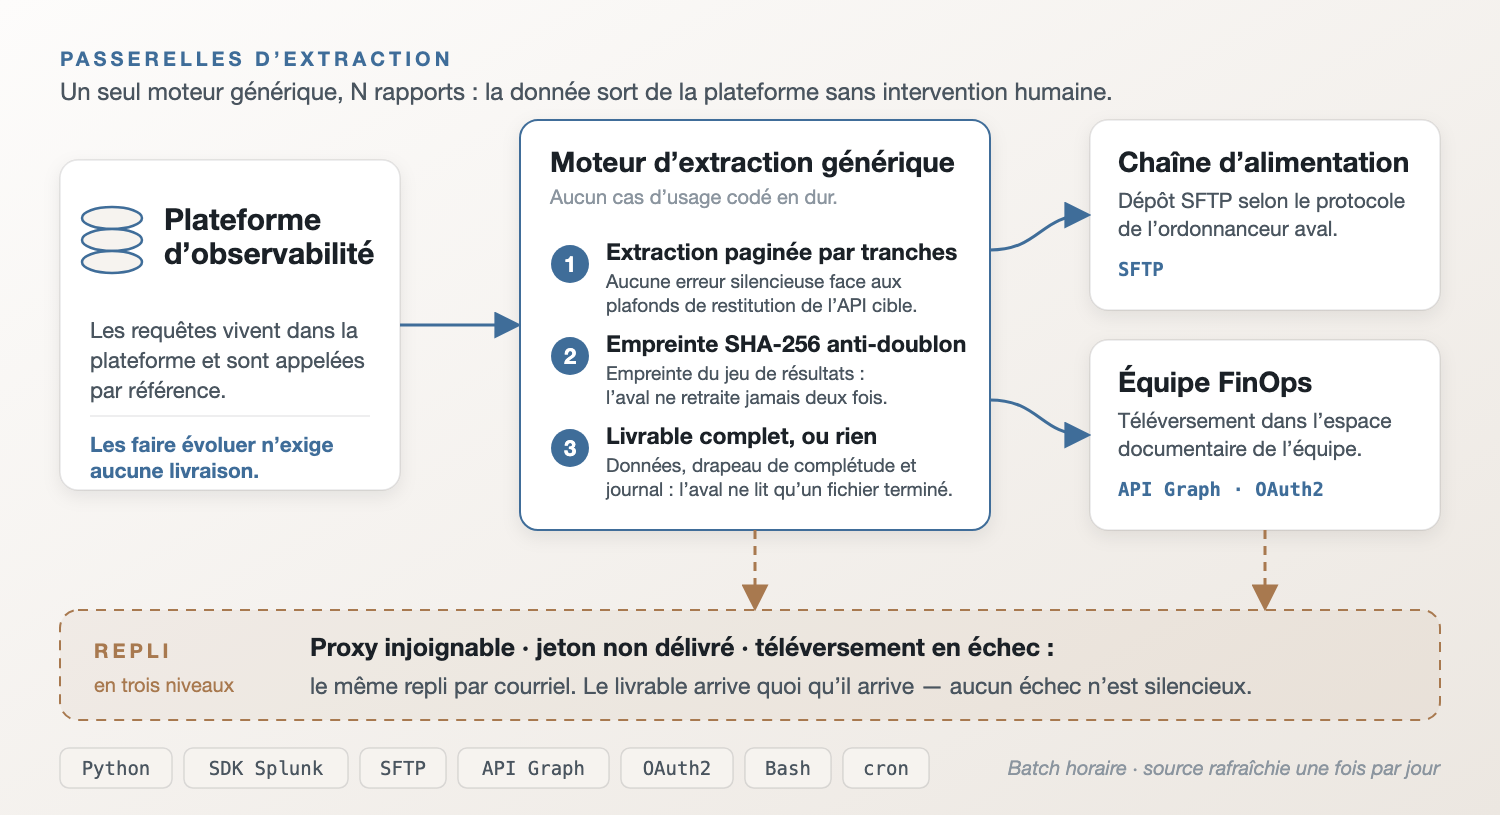
Passerelles d’extraction — sortir la donnée vers les systèmes tiers
Industrialisation
La plateforme d'observabilité est excellente pour calculer, mais les consommateurs de ces calculs n'y sont pas : une chaîne d'alimentation attend des fichiers déposés sur un serveur, une équipe FinOps travaille dans un espace documentaire. Deux batchs jouent le rôle de passerelle sortante, sans intervention humaine.
Un seul moteur générique, N rapports : aucun cas d’usage n’est codé en dur, tout est paramétré par l’environnement
Requêtes maintenues dans la plateforme et appelées par référence : les faire évoluer n’impose aucune livraison
Protection anti-doublon par empreinte SHA-256 du jeu de résultats — la chaîne aval ne retraite jamais deux fois la même donnée
Protocole de dépôt respecté à la lettre : données, drapeaux de complétude et journal, pour que l’ordonnanceur aval ne consomme qu’un fichier complet
Extraction paginée par tranches, pour dépasser sans erreur silencieuse les plafonds de restitution de l’API cible
Dégradation élégante en trois niveaux : proxy injoignable, jeton non délivré ou téléversement en échec conduisent tous au même repli par courriel
Résultats
Le livrable arrive quoi qu’il arrive — c’est le point clé de conception : aucun échec n’est silencieux
Batch horaire dont la source ne change qu’une fois par jour : aucun retraitement inutile en aval
Python
SDK Splunk
SFTP
API Graph
OAuth2
Bash
cron
Grand groupe d’assurance — 2025-2026
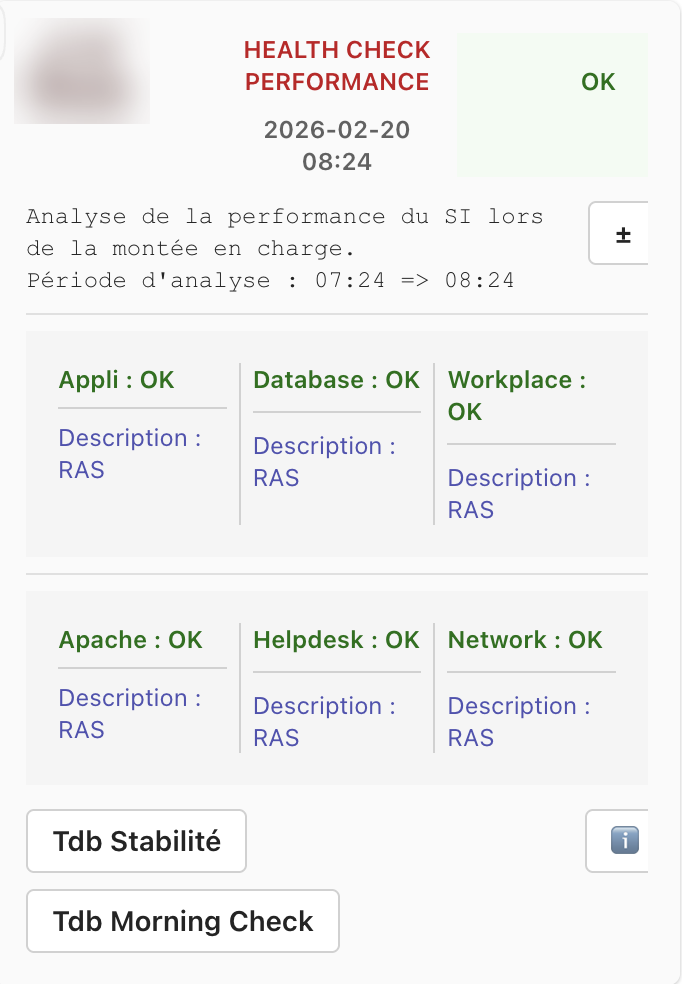
Morning Check automatisé — santé du SI en une carte
ChatOps
La validation quotidienne des performances du SI reposait sur une revue manuelle. Elle avait deux limites : elle mobilisait du temps expert chaque matin, et elle intervenait trop tôt pour observer la montée en charge réelle des utilisateurs. Le contrôle est industrialisé et diffusé automatiquement dans la conversation d'équipe, deux fois par matinée, dont une après la montée en charge.
Un statut global, calculé à partir de six domaines : applicatif, base de données, poste de travail, serveurs web, assistance et réseau
Chaque domaine porte ses propres règles de qualification, en OK / Warning / KO
Deux familles de seuils combinées : comparaison à la semaine précédente pour détecter la dérive, et seuils absolus sur une heure glissante pour détecter l’incident
Règle de disponibilité applicative fondée sur un indice de stabilité, pas sur une sonde isolée
Carte adaptative avec détails repliables et liens directs vers les tableaux de bord de niveau 2
Diffusion par automate, sans intervention humaine
Résultats
Revue matinale de plusieurs domaines ramenée à la lecture d’une seule carte
Deuxième passage programmé après la montée en charge : les dégradations qui n’apparaissaient qu’en charge sont désormais vues le matin même
Passage d’un contrôle déclaratif à un contrôle mesuré, avec des seuils explicites et discutables
Splunk Cloud
SPL
Power Automate
Adaptive Card 1.4
Teams
Grand groupe d’assurance — 2024-2026
Pilotage FinOps de la plateforme de données
FinOps
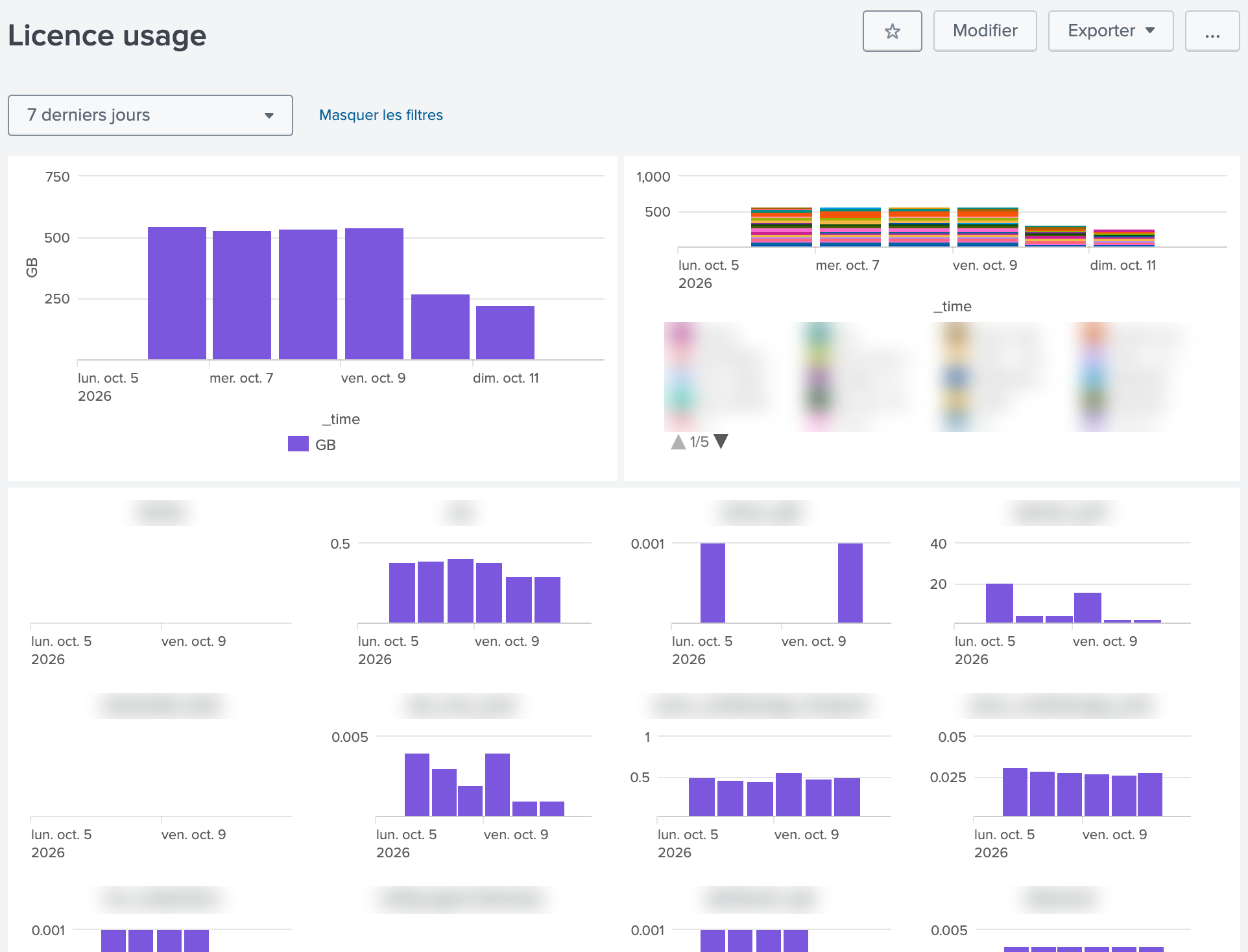
La licence de la plateforme de données est facturée au volume ingéré. Une dérive de volumétrie se découvrait sur la facture, donc trop tard pour être arbitrée. Il fallait la voir venir.
Exploitation des journaux internes de l’indexeur pour suivre la consommation jour par jour
Trois niveaux de lecture : consommation totale, répartition par couple source × index, détail tabulaire
Outil de référence pour arbitrer les entrées de données avant qu’elles n’impactent le contrat
Résultats
La dérive de volumétrie devient visible et arbitrable avant facturation
Décisions d’ingestion appuyées sur une mesure, plus sur une estimation
Splunk Cloud
SPL
Grand groupe d’assurance — 2025
Supervision d’une chaîne métier 100 % conteneurisée
Kubernetes & RPA
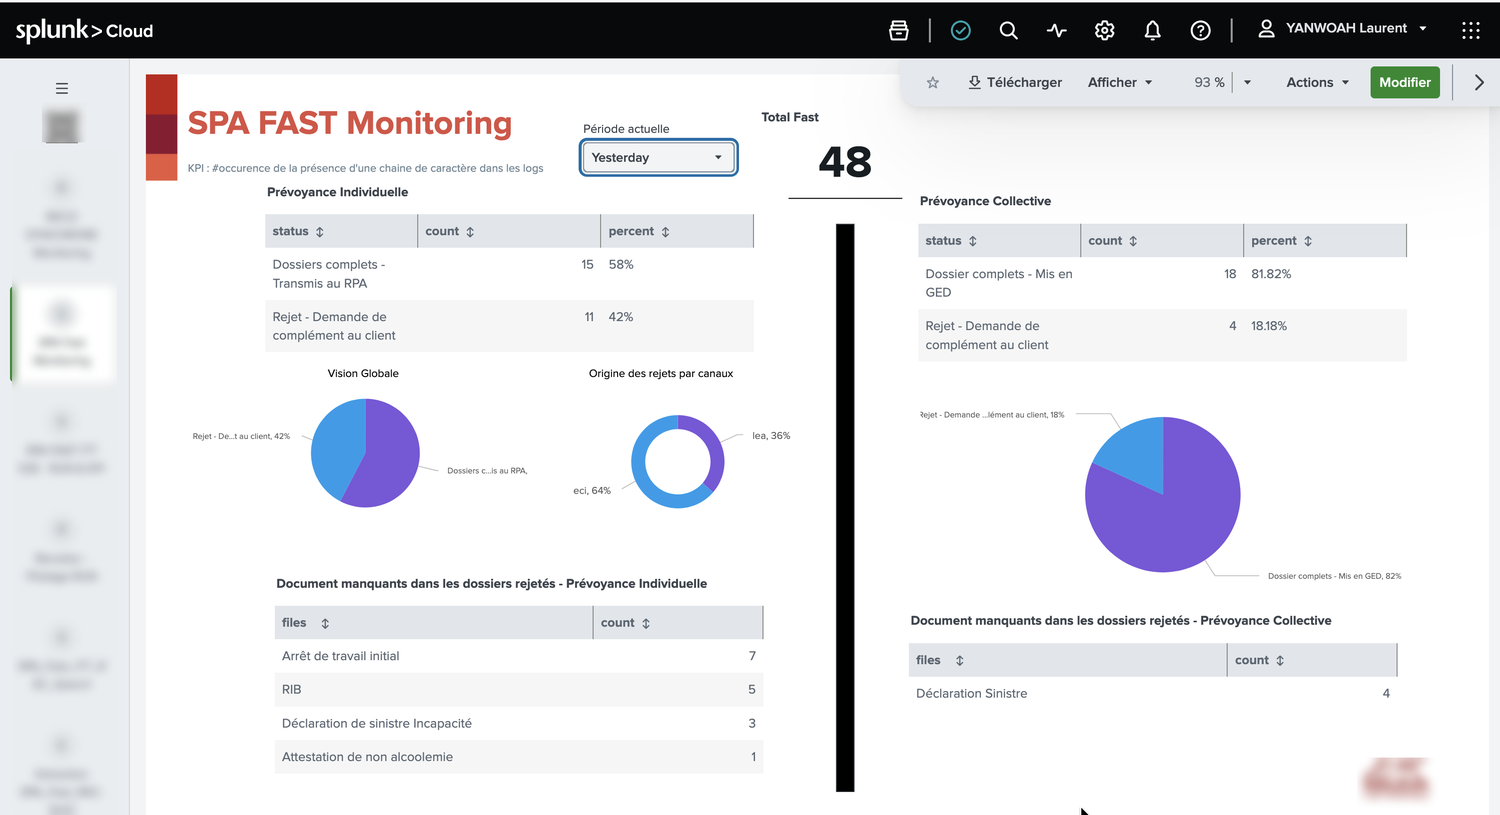
Une chaîne de traitement de dossiers de prévoyance, entièrement conteneurisée et terminée par un robot logiciel, ne produisait aucune télémétrie applicative classique. La seule matière disponible était le journal des conteneurs.
Supervision reconstruite exclusivement à partir des logs de conteneurs, filtrés par étiquette de référentiel
Entonnoir métier matérialisé étape par étape, chaque volumétrie obtenue par reconnaissance d’un motif précis dans le journal du composant correspondant
Deux compteurs d’anomalie distincts : rejets métier et échecs techniques
Extension au pilotage du run et aux extractions associées
Résultats
Une chaîne jusque-là aveugle devient mesurable de bout en bout, du dépôt au robot
Les pertes de dossiers se localisent à l’étape près, au lieu d’être constatées globalement
Splunk Cloud
SPL
Kubernetes
RPA
Grand groupe d’assurance — 2025-2026
Contrôle automatisé de conformité des bases de production
Conformité
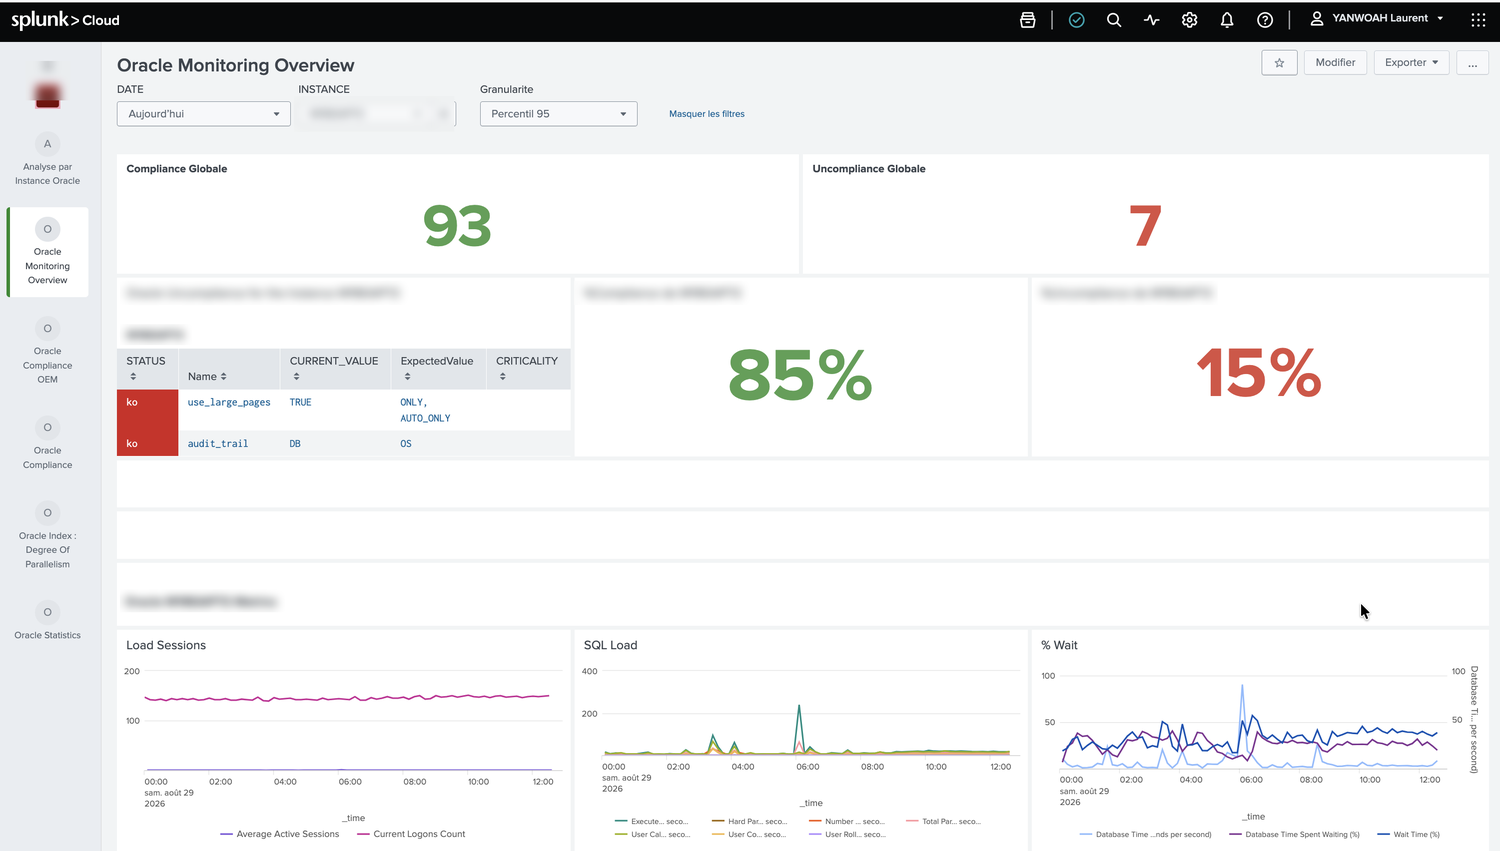
Le paramétrage des instances de base de données de production dérivait au fil des interventions, sans que personne ne puisse dire de combien ni où. Les écarts se découvraient à l'occasion d'un incident.
Collecte du paramétrage de chaque instance, puis confrontation à une valeur attendue tenue dans un référentiel
Taux de conformité par instance et répartition des écarts par niveau de criticité
Détail ligne à ligne : paramètre, valeur courante, valeur attendue
Vues complémentaires : analyse par instance, monitoring, parallélisme des index, statistiques
Résultats
La dérive de paramétrage devient un indicateur suivi, au lieu d’une découverte d’incident
Écarts hiérarchisés par criticité : l’équipe traite ce qui compte d’abord
Splunk Cloud
SPL
DB Connect
Oracle
Grand groupe d’assurance — 2024-2025
Compte rendu de performance d’une filiale, du siège aux agences
Filiale
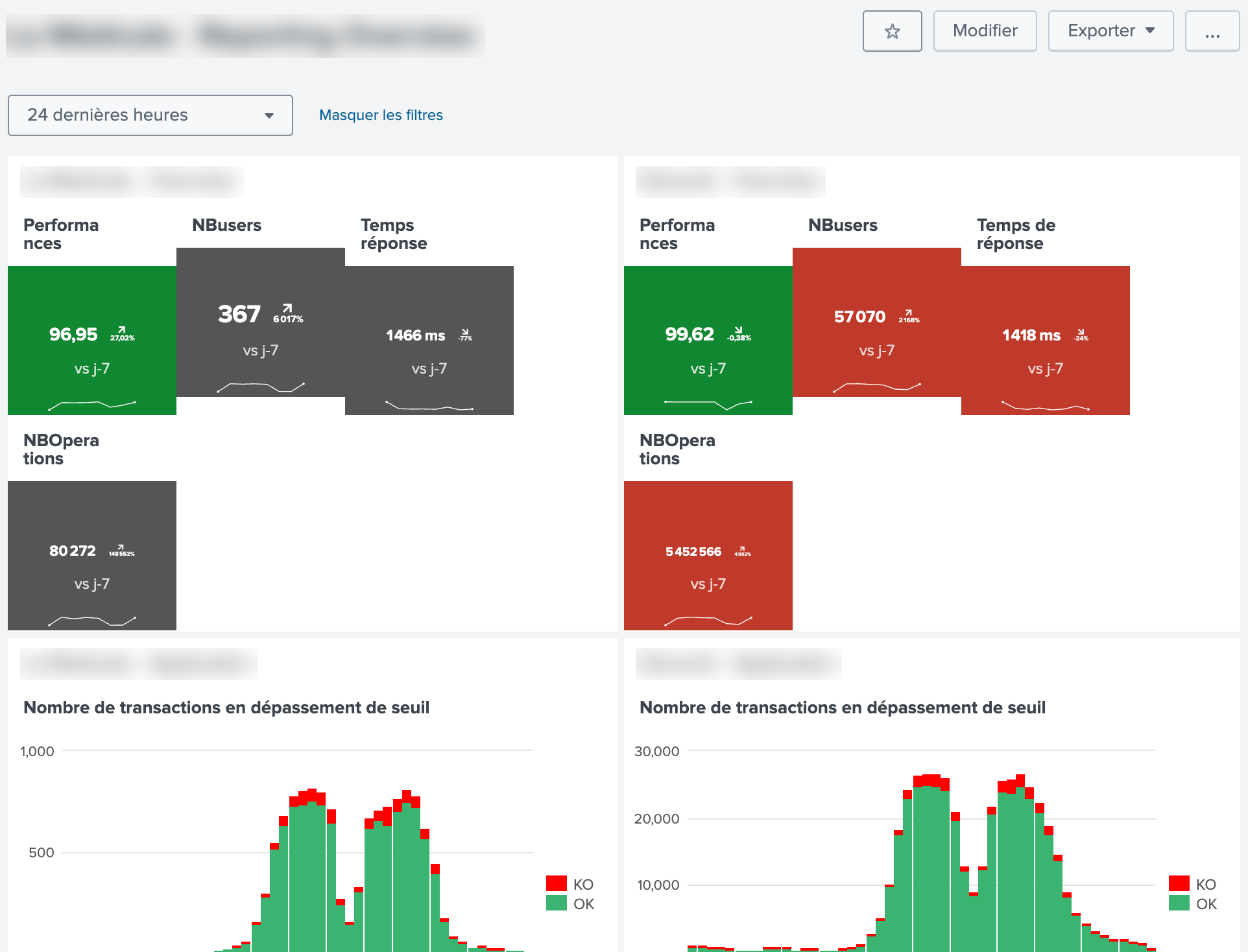
L'intégration d'une filiale au système d'information du groupe devait être pilotée sur des faits : les utilisateurs de la filiale travaillaient-ils dans des conditions comparables à celles du groupe, au siège comme en agence ?
Croisement de deux mondes : le référentiel des utilisateurs de la filiale, enrichi de leur affectation, et la télémétrie des transactions applicatives
Indicateur de ressenti utilisateur calculé sur les transactions rapides
Sept restitutions : vue d’ensemble, activité informatique, poste de travail, synthèse, investigation, agences, comparaison d’activité
Suivi du statut de bascule et investigation des écarts de performance entre les deux périmètres
Résultats
Plus de 700 utilisateurs suivis, siège et agences distingués
Le pilotage de l’intégration s’appuie sur des mesures d’expérience réelle, pas sur des déclarations